
RDSS Job Radar - 研發替代役職缺雷達
era: agent
created_at: 2026/10/12 01:00:00
定時去看求職網站上的職缺,判斷是不是研發替代役的缺、適不適合我,然後整理成儀表板與週報。
這是個人工具,沒有開源;爬下來的職缺資料也不方便公開,所以這一頁以架構和流程為主。
為什麼會有這個服務
找研發替代役的缺很花時間:職缺散在不同的網站,是不是研替的缺常常要點進去讀完才知道,而且職缺每天都在變。
這種「每天重複、規則大致明確、但又需要讀懂內容」的事情,剛好很適合交給程式加上 LLM 來做。
Tech Stack
Worker:Python、curl_cffi、Playwright、Modal(排程與執行)、GeminiBackend:Go、Gin、GORM、Uber FX、OpenAPI+oapi-codegen、PostgreSQLFrontend:SvelteKit+Svelte 5CI/CD:GitHub Actions(self-hosted runner)、Docker Compose、modal deploy
宏觀的系統架構
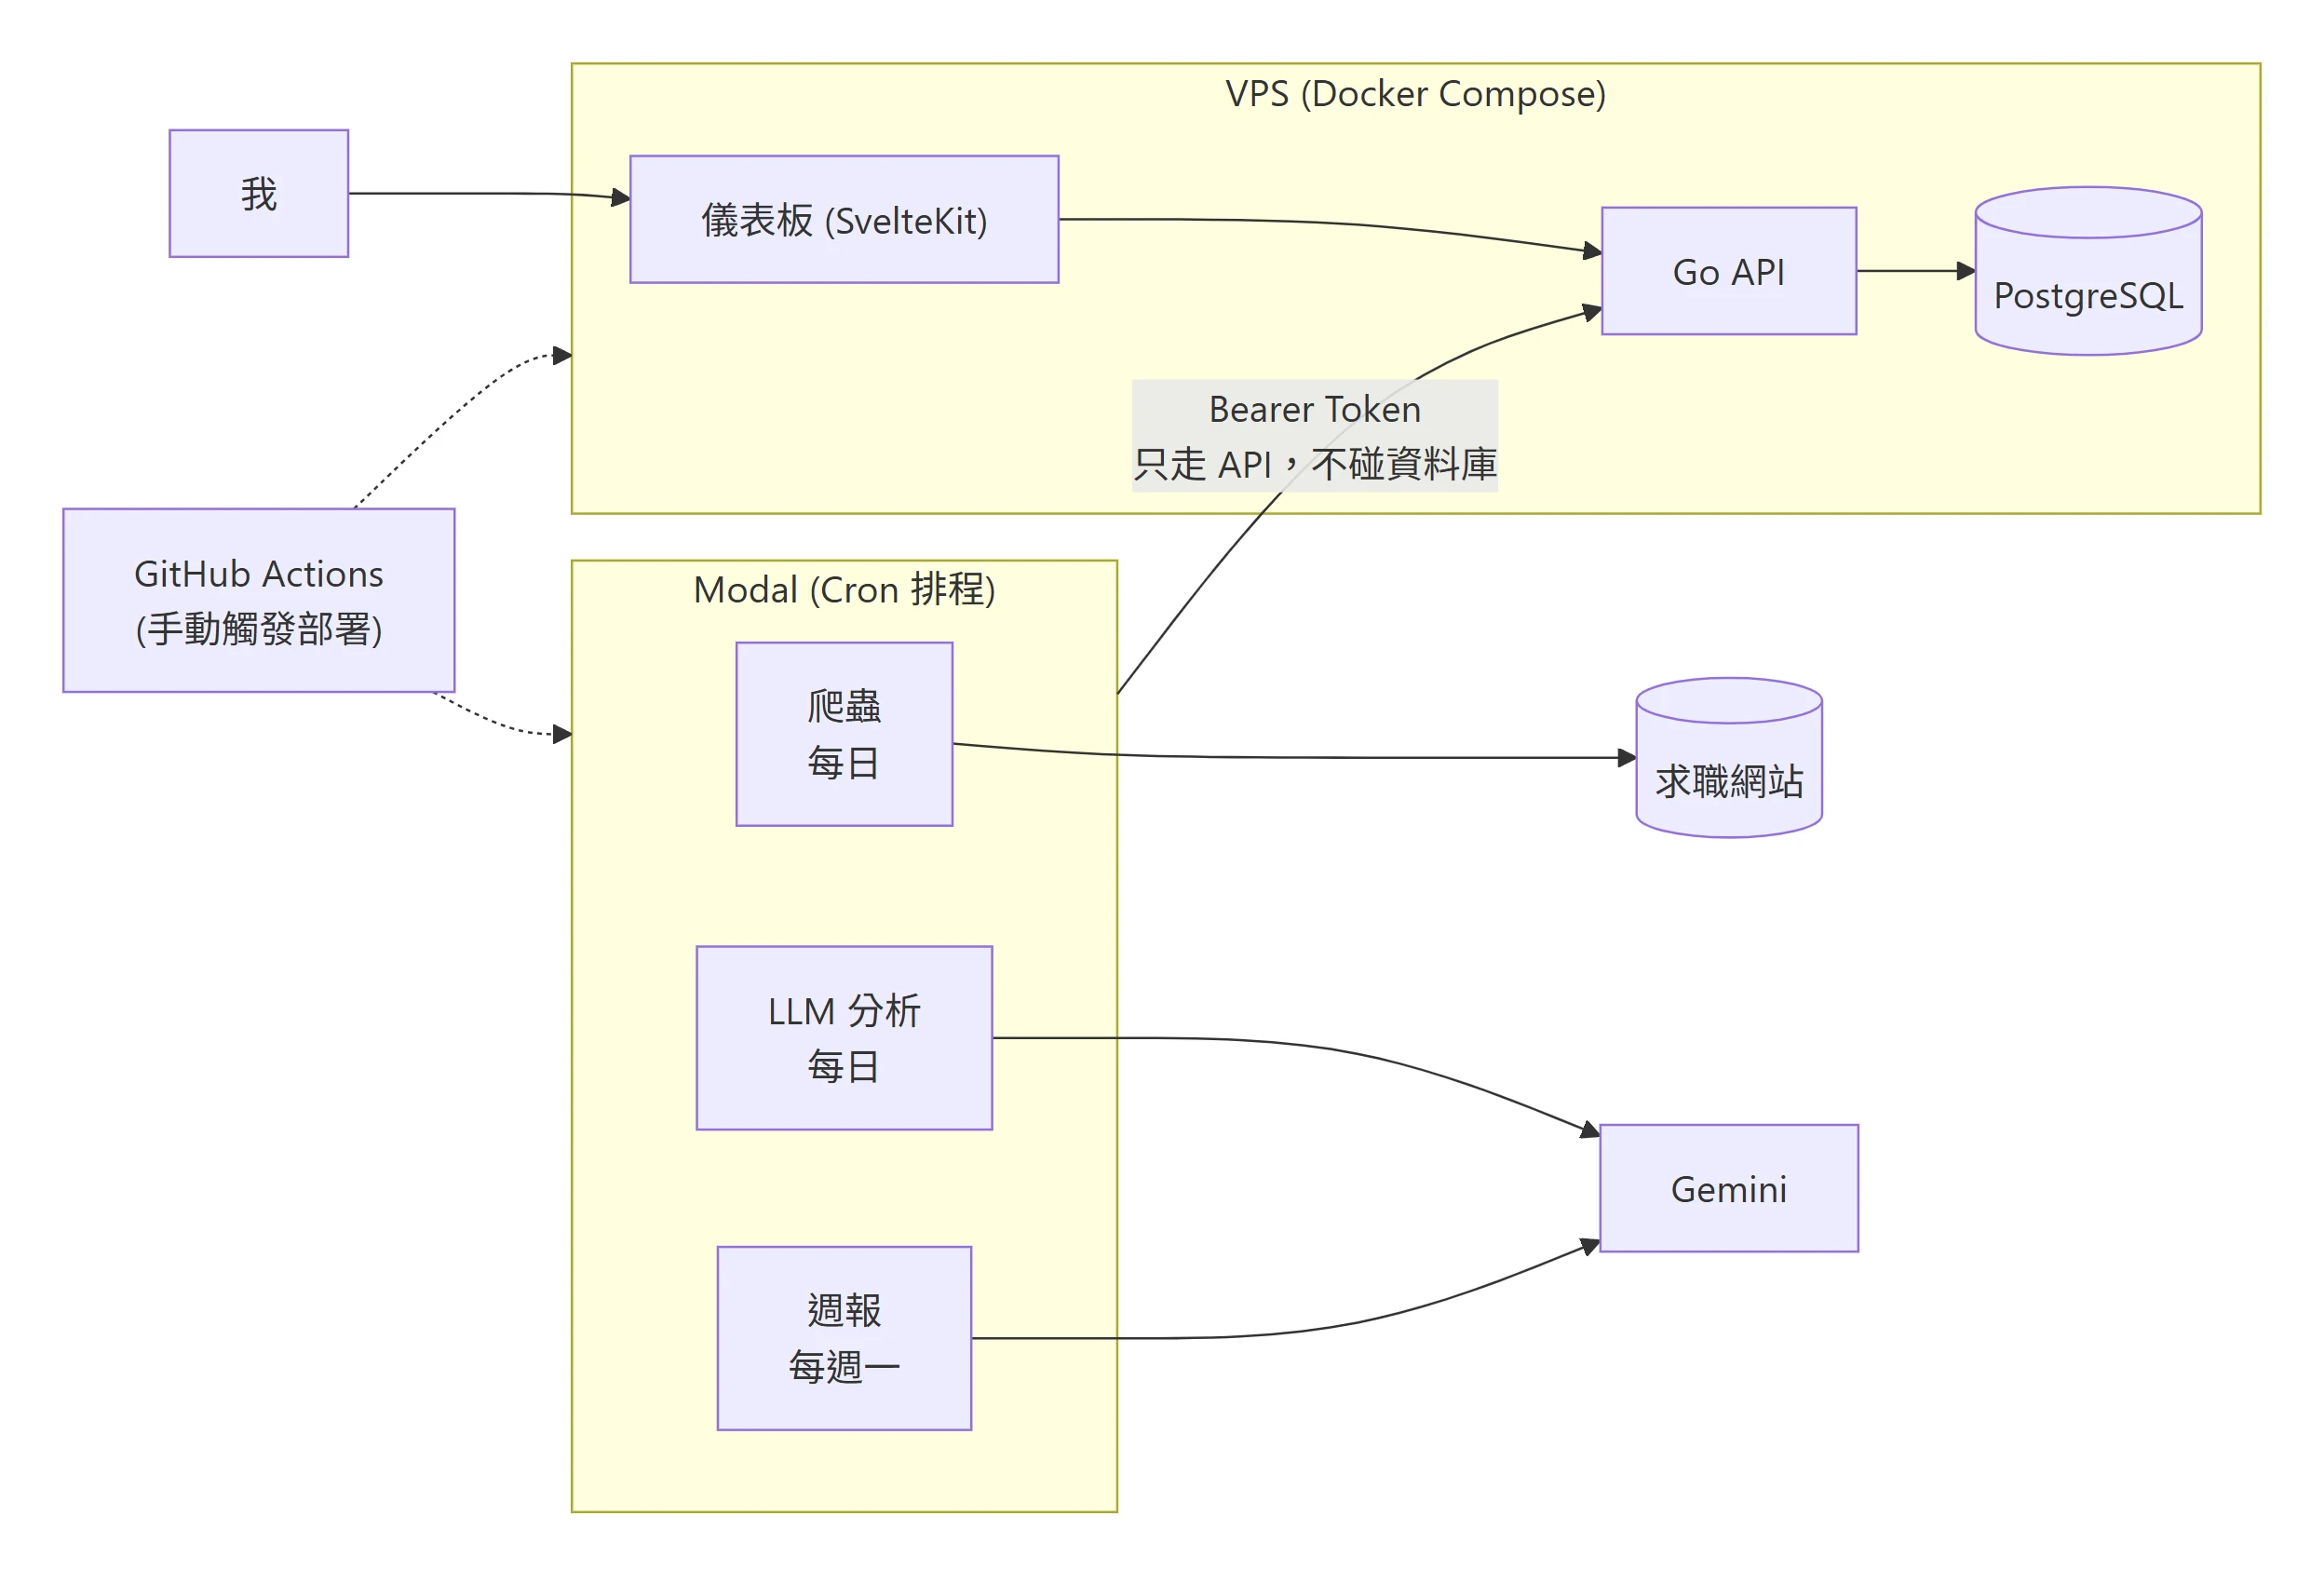
爬蟲和分析都放在 Modal 上用 Cron 排程跑,VPS 上只有 API、資料庫和儀表板,所以 VPS 很輕,爬蟲和 LLM 這種跑一下就結束的工作不用佔著一台機器。
Modal 和 VPS 之間只靠一組 Bearer Token 和 API 溝通,Worker 自己不碰資料庫。
API 是 Contract-first:先寫 OpenAPI,Go 的 server 介面由它產生,Worker 那邊的 client 也是照同一份規格。
爬取流程
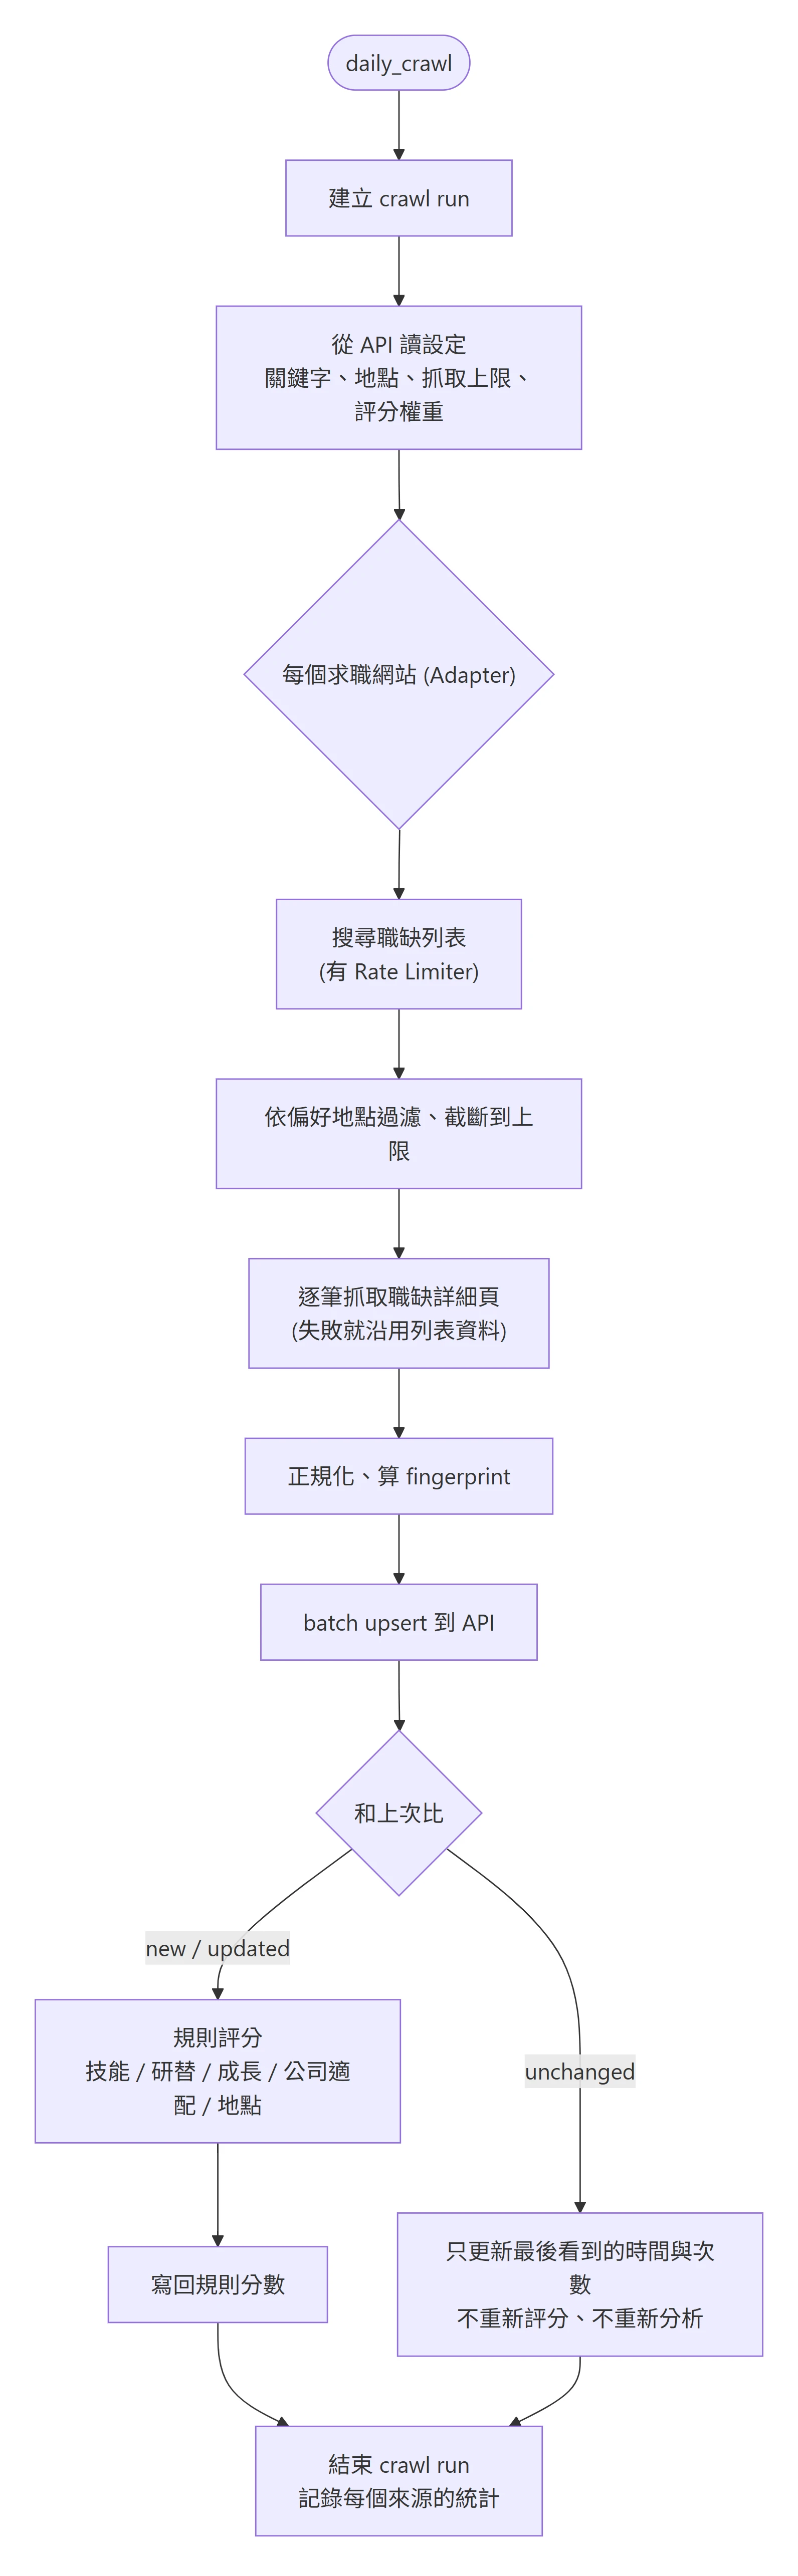
每個求職網站是一個 Adapter,繼承同一個抽象類別,只要實作「搜尋」和「抓詳細頁」兩件事,Rate Limit、Session、錯誤分類這些都在基底處理好了。有 JSON API 的網站直接打 API,沒有的就用 Playwright 開瀏覽器抓。要支援新的網站就是多一個 Adapter,其他地方不用動。
關鍵字、偏好地點、抓取上限和評分權重,都是從儀表板的設定頁讀出來的,不用改 code 或重新部署。
為什麼不會每天把同一批職缺重丟給 LLM
每筆職缺都會算一個 fingerprint,upsert 的時候拿它比對:
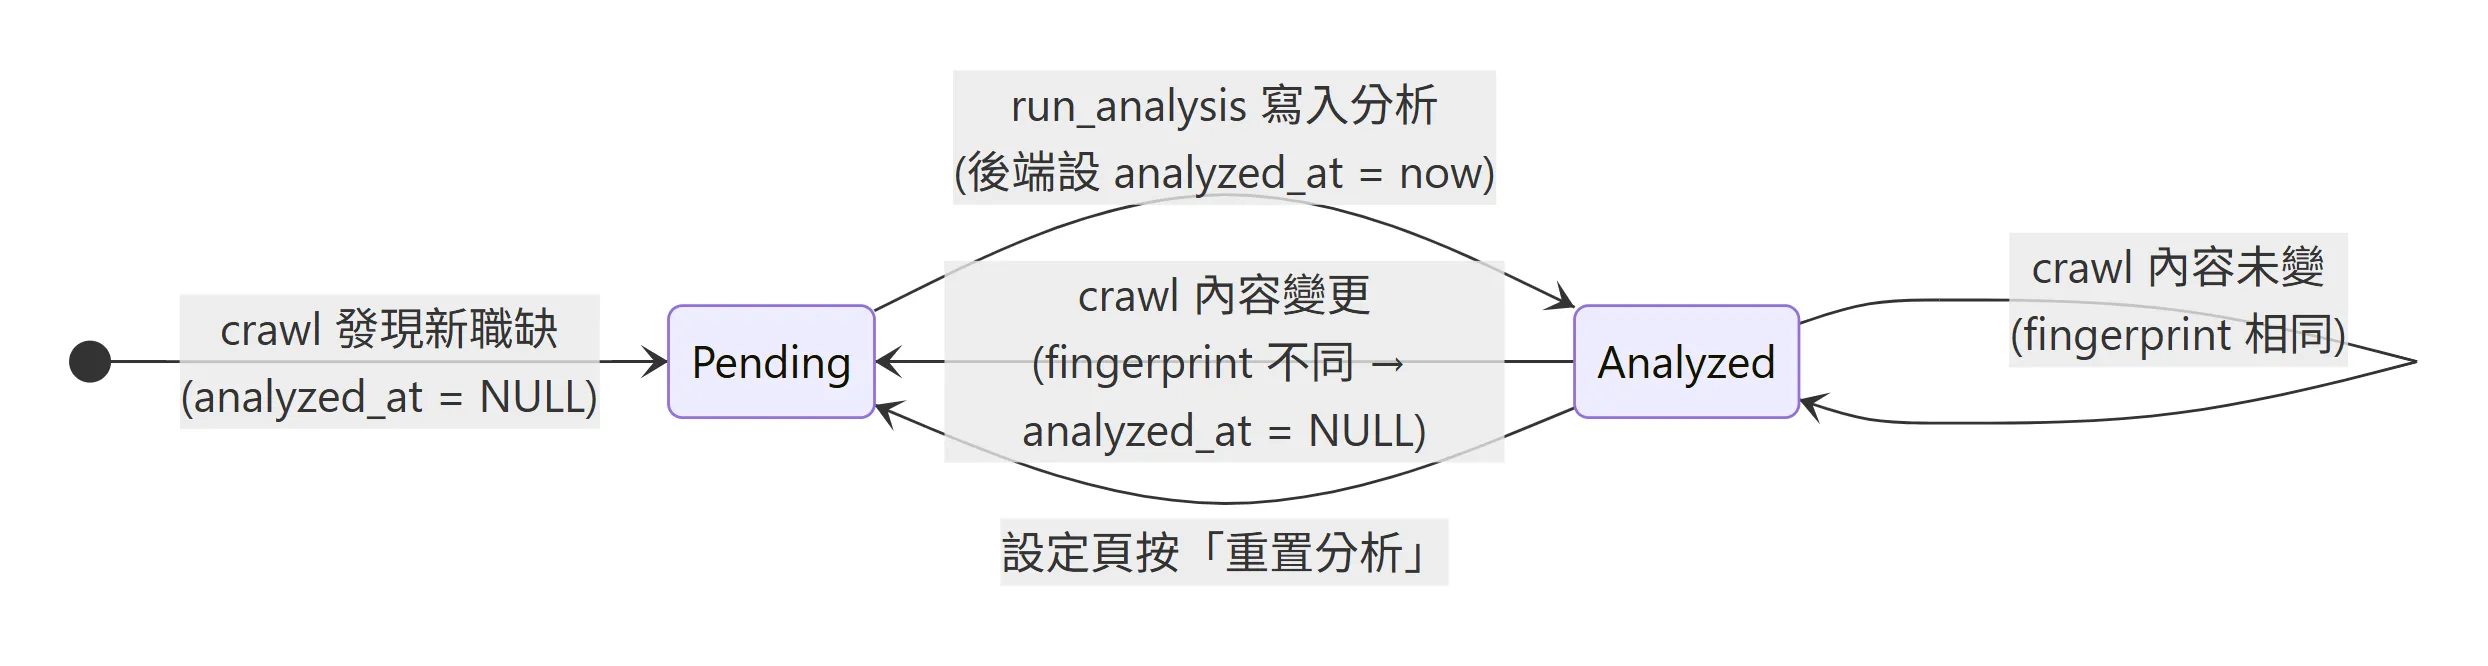
- 新職缺,或是內容變了:
analyzed_at清成NULL,等待分析 - 內容沒變:只更新「最後看到的時間」和出現次數,分數和分析都保留
所以 LLM 只會處理真的有變化的職缺,規則評分也只對 new / updated 重算。
分析與週報
評分分成兩層:
- 規則評分:在爬取當下就算完,五個面向(技能、研替、成長、公司適配、地點)各有權重,權重和關鍵字一樣可以在設定頁調
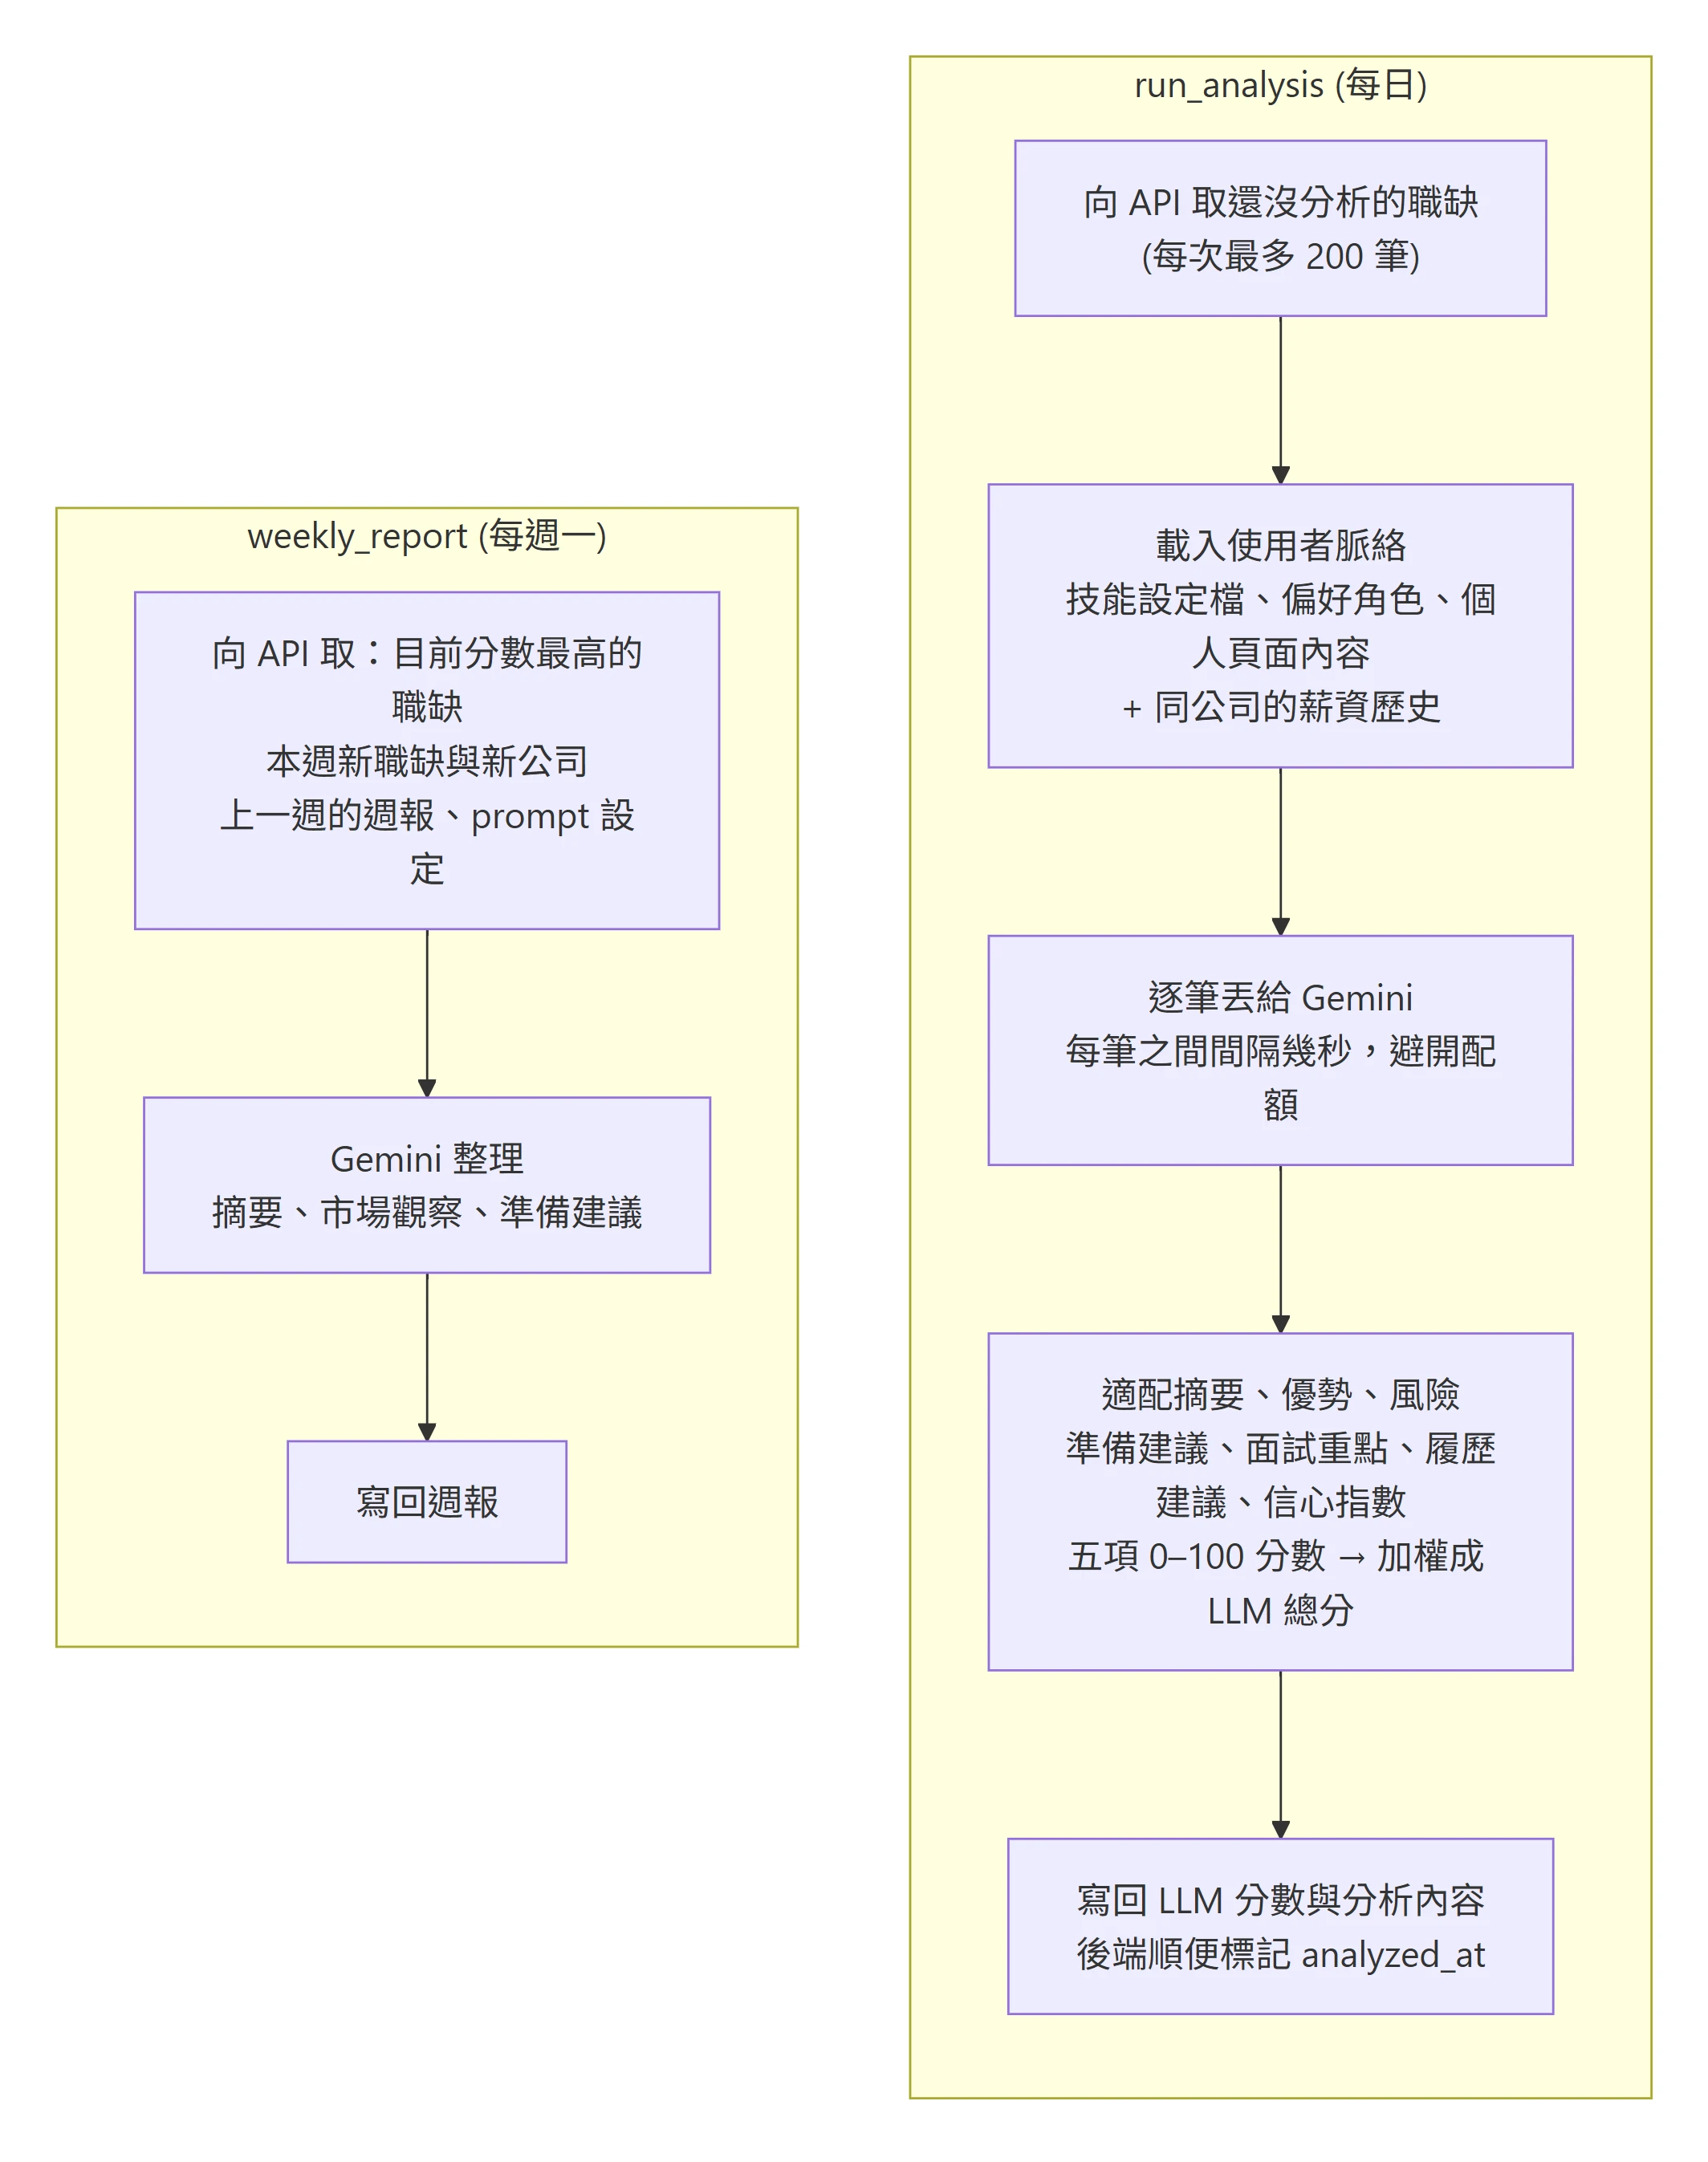
LLM分析:另一個排程,每次只拿還沒分析過的職缺,連同我的技能設定檔和個人頁面的內容一起丟給Gemini,產出適配摘要、優勢、風險、準備建議、面試重點、履歷建議,以及一組獨立的LLM分數,和規則分並列顯示
週報則是每週一把這一週新出現的職缺與公司、目前分數最高的幾筆,加上上一週的週報一起整理,寫成摘要、市場觀察和準備建議。
儀表板
儀表板有五頁:總覽(今日職缺、高分職缺、Top 5)、職缺列表(可依分數、來源、是否研替篩選)、單一職缺(規則分與 LLM 分並列、分析內容)、爬蟲歷史(每次執行的狀態與各來源統計)、週報,以及一頁設定。
這裡的爬蟲架構後來被沿用到 PTIS。