PTIS - 個人技術情報系統
era: agent
created_at: 2026/10/12 04:00:00
Personal Technical Intelligence System,幫我每天去看技術文章的系統:抓文章、去重、產生附引用的摘要、依照我的興趣評分,最後整理成每日的 digest。
而它最有趣的地方是:它會自己發現新的網站,然後自己寫爬蟲。
自動發現新來源
技術文章很常會引用外部的來源,這些連結在處理文章的時候都會被記錄下來,累積成一張 link graph。
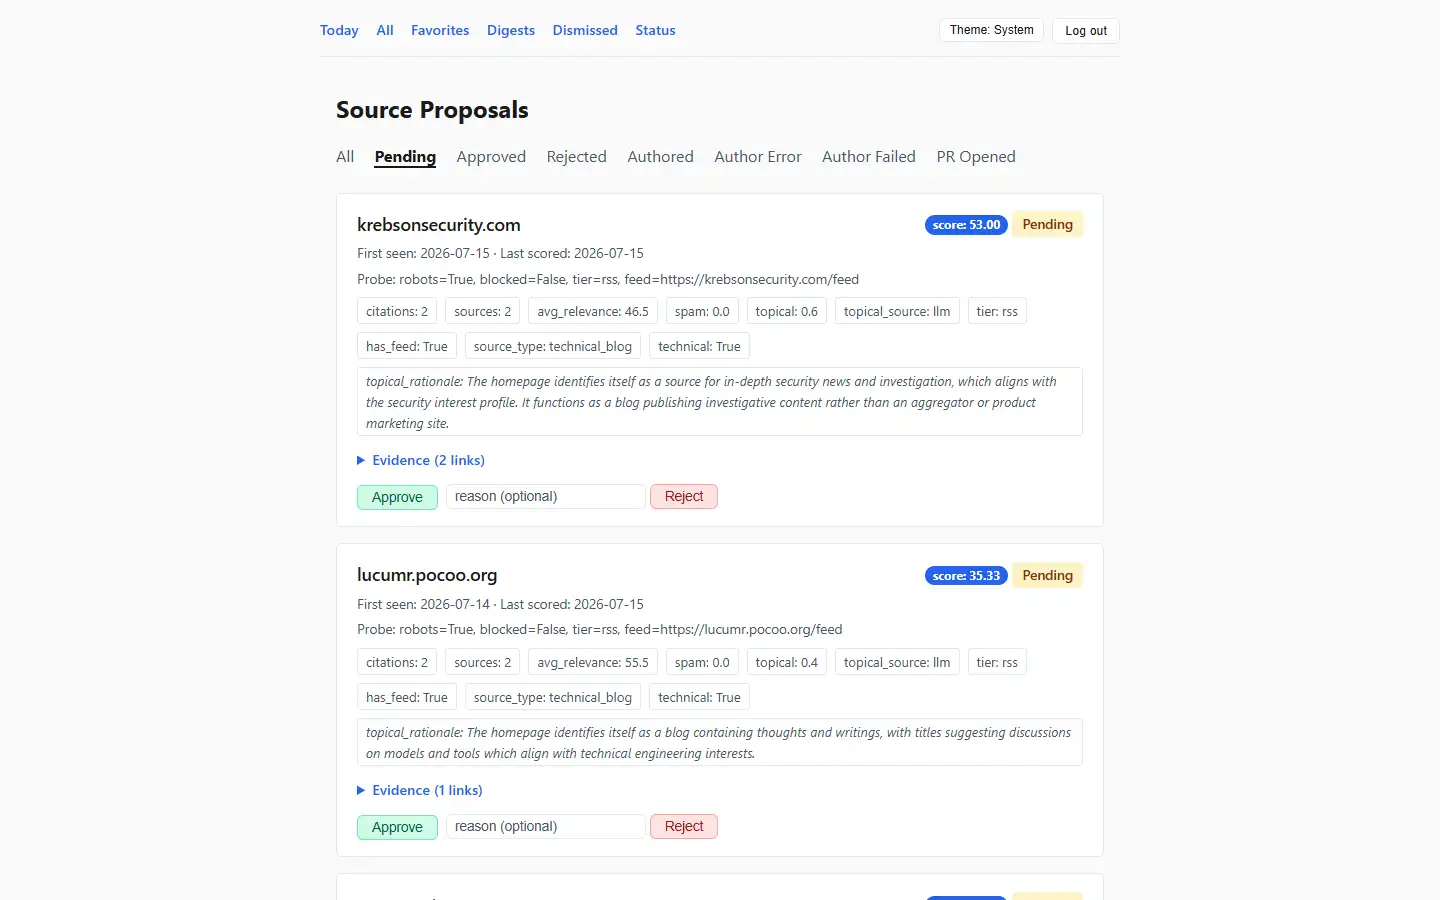
系統會定期從這張圖去找「常常被我信任的來源引用,但我還沒有在追」的網站,評分之後變成一筆提案,出現在後台等我審。
文章的外部連結 -> link graph -> 候選網站評分 -> 提案
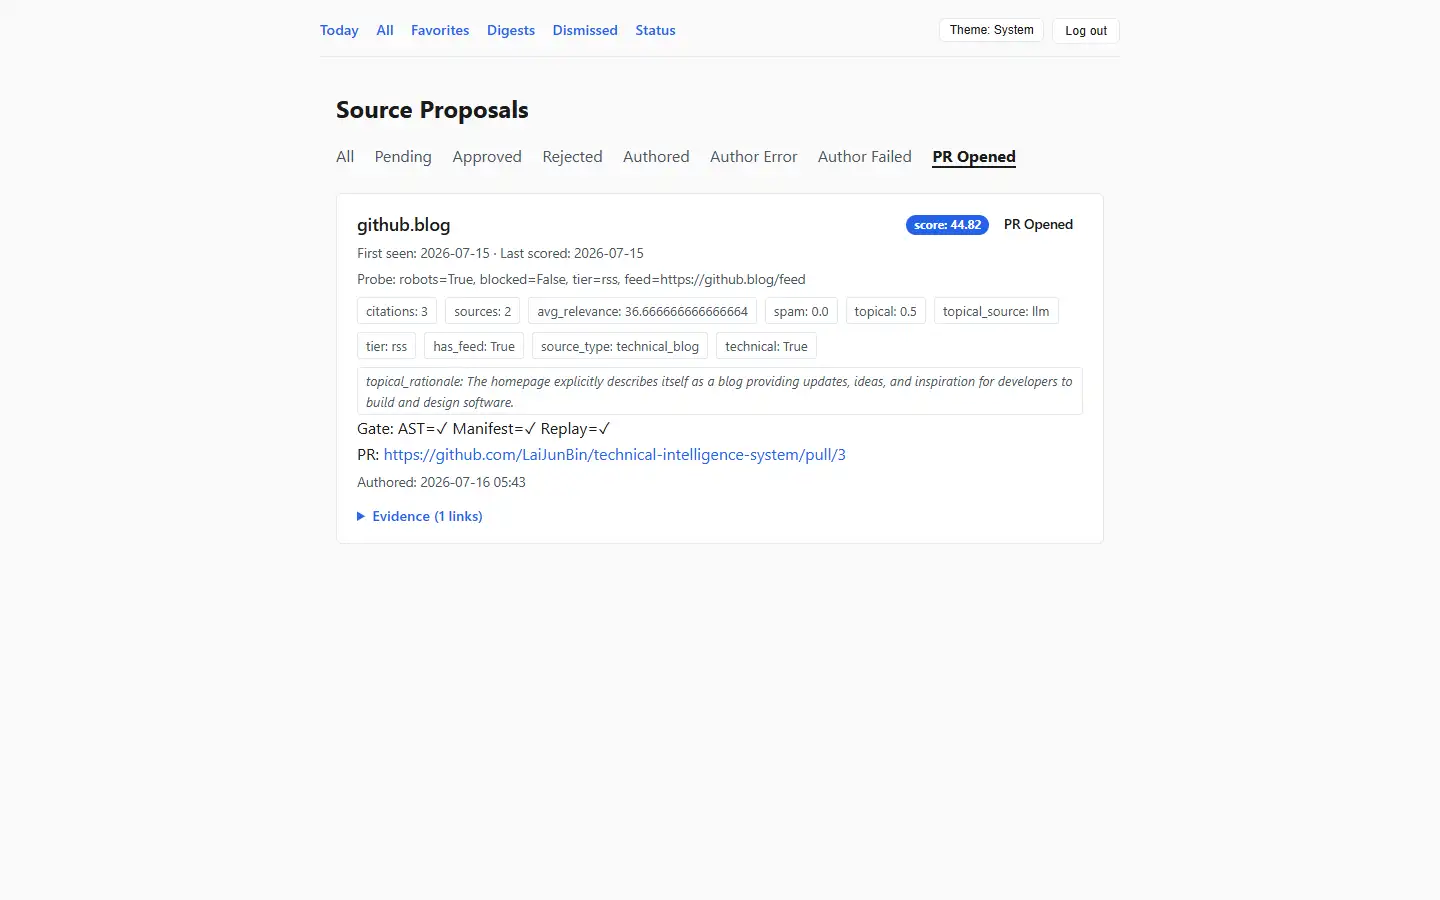
    -> 我在後台核准 -> AI 產生 adapter -> 過 gate -> 我在後台按下 Open PR
    -> CI 再驗一次 -> 我 review + merge -> 自動部署,新來源進入排程
所以我要做的事情只有兩個:在後台決定要不要追這個網站,以及最後 review 那一個 PR。
核准之後 AI 會自己寫 adapter、過完 gate 再開 PR,後台可以看到每一關的結果和 PR 的連結:
AI 寫的爬蟲要怎麼放心讓它跑
讓 AI 自己寫程式然後自己上線,聽起來就很危險,所以這邊設了幾道防線,而且自動化不會放寬任何一條:
- 產生的
PR只能動到該網站自己的adapter目錄,塞不進平台本身的程式碼 - 先過靜態檢查,再用錄下來的
fixture重放驗證,CI上會獨立再跑一次 adapter只能透過受限的SDK連線,robots.txt不允許就直接中止- 連續失敗三次就放棄,避免壞掉的
adapter一直燒LLM預算 - 抓回來的文章內容永遠不會觸發任何動作,要抓誰是從連結算出來的,不是
LLM看完文章決定的 - 最後一關永遠是人:
PR沒有merge就不會上線
架構
- 平台:
Python+FastAPI,介面是Jinja+htmx的SSR,資料庫是PostgreSQL+pgvector,跑在自己的VPS - 爬蟲與分析:跑在
Modal上,定時觸發,抓完再把結果送回平台 - 摘要:
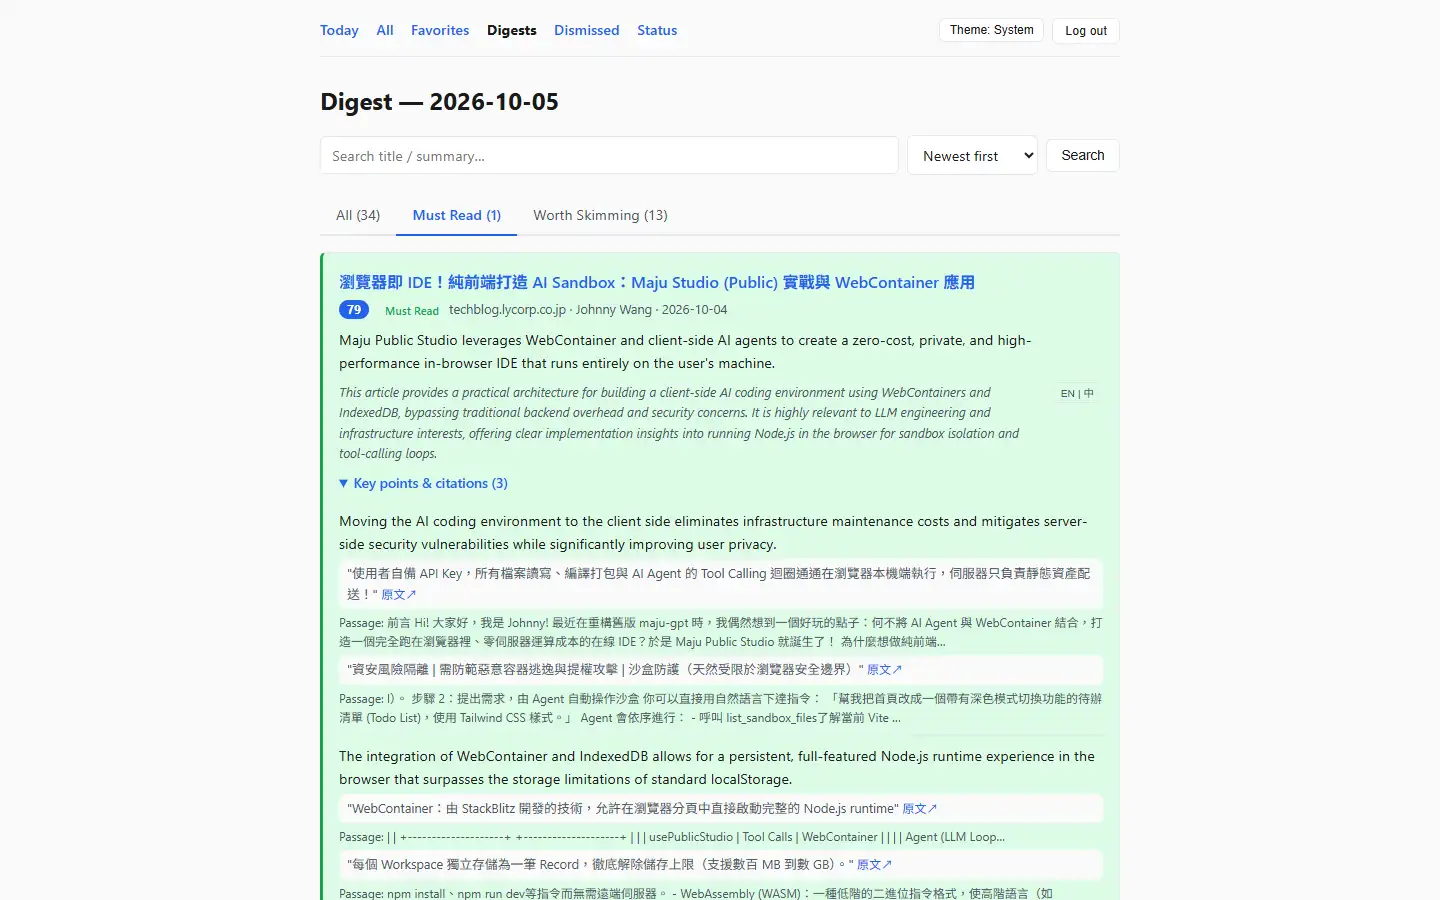
LLM產生的每一句引用都要能在原文裡逐字找到,找不到就不算數
- 去重:完全相同與相似(
SimHash)的文章會被歸在一起,重複的不會再花LLM的錢
爬蟲的基礎架構沿用自先前做的 RDSS Job Radar。
其他畫面
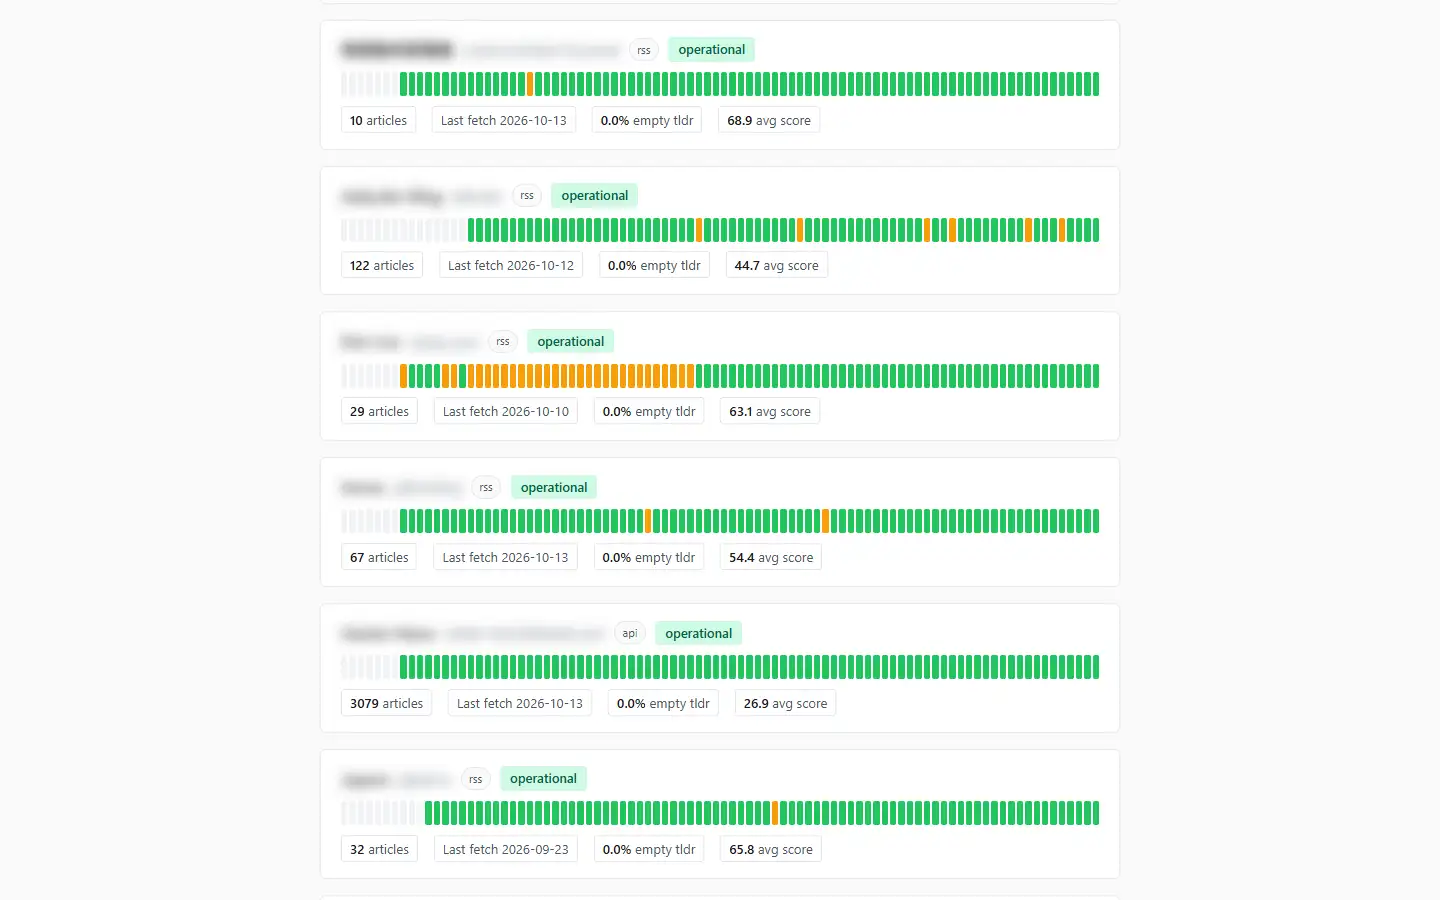
每個來源的健康狀態,一眼看出哪個網站很久沒抓到東西:
做成 PWA,手機上也能看: